Re-creating Amadeus System: AI Makise Kurisu ala Steins;Gate
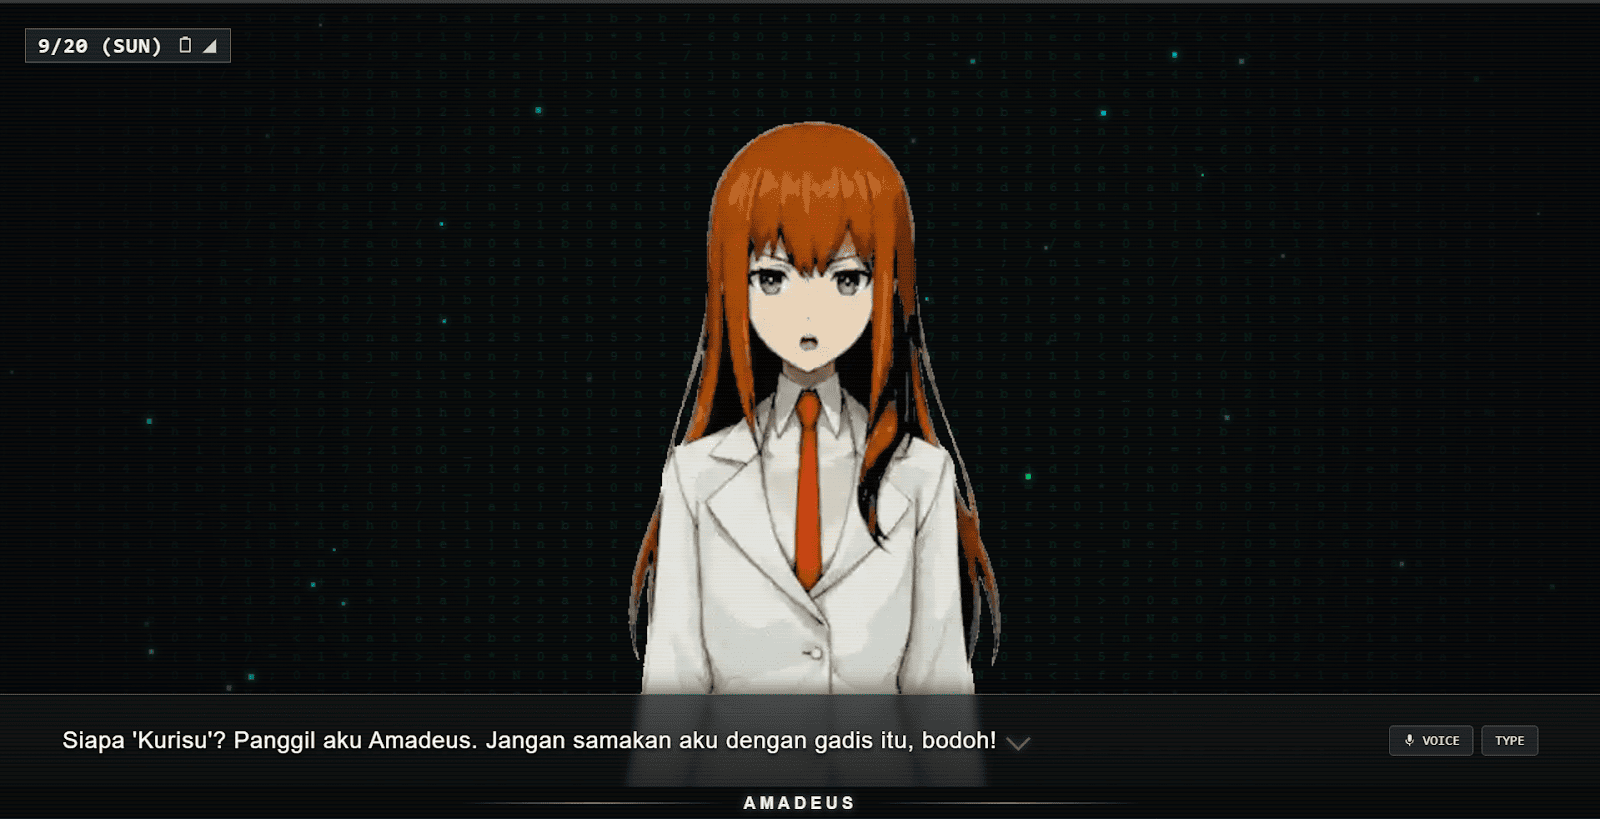
Proyek ini berawal dari hasil gabutku di kosan. Waktu itu aku lagi scrolling media sosial dan nemu video reels tentang seseorang yang bikin Amadeus System pakai IoT.
Melihat video itu, aku langsung teringat jaman SMP dulu pernah nonton anime Steins;Gate, anime science fiction yang di salah satu episodena ada sistem AI bernama Amadeus, sistem yang menyimpan ingatan dan kepribadian karakter Kurisu Makise. Dari situ aku mulai ngulik lagi: "Gimana sih cara bikin ini sendiri?"
Akhirna aku memutuskan untuk mengeksekusi. Ini rangkuman alur teknis dan proses pengembangannya dari awal sampai jadi.
1. Konsep & Arsitektur Sistem
Secara garis besar, aku membagi sistem ini menjadi 4 pilar utama agar AI bisa merespons suara secara real-time:
[Mic Input] ──> (1. STT) ──> [Teks] ──> (2. LLM / Otak) ──> [JSON] ──> (3. TTS + RVC) ──> (4. Visual & Lip-Sync)
- Pendengaran (Speech-to-Text): Menangkap suara dari mikrofon browser.
- Otak & Kepribadian (LLM): Mengolah logika dan sifat tsundere ala Makise Kurisu.
- Suara (TTS & Voice Conversion): Mengubah teks menjadi ucapan dan menyesuaikan timbre suaranya.
- Visual Avatar & Lip-Sync: Menampilkan karakter 2D yang merespons audio secara visual.
2. Pembuatan Visual Novel Avatar (Sprite Sheet & Lottie)
Karena ingin melihat wujud kasarnya dulu, aku mulai dari bagian visual:
- Aku mendesain sprite sheet karakter Kurisu yang berisi variasi ekspresi dasar serta bentuk mulut (visemes) untuk fonem A, I, U, E, dan O.
- Potongan gambar ini aku susun dan jadikan file Lottie (.json) supaya gampang dikontrol via kode di React.
- Frontend-nya aku bangun pakai React. Setelah tampilan kasaran visual novel-nya beres, aku baru lanjut menggarap bagian backend.
3. Eksperimen Suara Kurisu & Kendala Free Tier
Di bagian backend, aku mikir gimana cara bikin TTS yang suaranya mirip Kurisu. Ga harus 100% identik, minimal masih nyerempet karakter aslinya lah.
Coba Kloning Pakai GPT-SoVITS
- Eksperimen pertama yang kucoba adalah kloning suara pakai GPT-SoVITS.
- Karena spek laptopku terbatas, aku manfaatin Google Colab buat prosesnya. Aku mulai kumpulin sampel suara Kurisu dari anime.
- Sayangnya hasilnya ga sesuai ekspektasi. Setelah dicoba berkali-kali, prosesnya sering terhenti dan reset di tengah jalan karena koneksi internet di kosan yang kurang stabil.
Nemu Sample di HuggingFace & Masalah Limit API
Akhirnya aku coba cari alternatif di Google dan nemu checkpoint / sampel suara Kurisu yang sudah di-publish di HuggingFace. Awalnya aku langsung pakai service TTS gratisan di HuggingFace. Tapi karena kena batasan free tier, API-nya selalu terkena rate limit saat di-fetch dari frontend.
4. Beralih ke FastAPI, Edge-TTS, Gemini API, dan Realita Latensi RVC
Karena keterbatasan biaya dan limit dari service gratisan luar, aku merombak arsitektur backend-nya:
- Backend FastAPI: Aku ganti backend-nya menggunakan FastAPI yang di-deploy di VPS.
- LLM (Gemini 2.5 Flash): Untuk otaknya, aku pakai API gratisan
gemini-2.5-flash. System prompt-nya disesuaikan sedemikian rupa agar jawaban tidak terlalu panjang (menghemat token) tapi karakter personality Makise Kurisu tetap dapat. - Kombinasi Edge-TTS + RVC: Aku pakai Edge-TTS (
id-ID-GadisNeural) untuk generate audio dasar Bahasa Indonesia. Audio mentah ini lalu dilempar ke RVC (Retrieval-based Voice Conversion) menggunakan file.pthKurisu dari HuggingFace untuk mengubah timbre suaranya.
Breakdown Detikan Latensi Backend
Saat pertama kali berhasil jalan dan kuuji via endpoint /api/chat, total waktu tunggu yang tercatat mencapai 20,18 hingga 26,62 detik per satu kali respons.
Begitu dicetak log processing_time-nya, kelihatan jelas mana komponen yang memakan waktu paling lama:
JSON
- Gemini API (~1,5 detik): Mengolah prompt dan menghasilkan teks balasan.
- Edge-TTS (~2,2 detik): Merender teks Bahasa Indonesia menjadi file audio
.wavawal. - RVC Conversion (~15,7–22,4 detik): Memakan waktu paling dominan karena proses inferensi model neural network RVC dipaksa berjalan di CPU VPS (tanpa GPU NVIDIA).
5. Menghidupkan Lip-Sync Real-Time di Frontend
Untuk menggerakkan bibir avatar Lottie secara pas, aku manfaatin Web Audio API bawaan browser.
Audio .wav hasil RVC diputar di frontend, lalu AnalyserNode bakal membaca rata-rata volume (amplitude) per-frame (nilai 0–255):
- Volume < 10: Mulut netral / diam.
- Volume 10–40: Fonem U (terbuka sedikit).
- Volume 40–80: Fonem O (terbuka sedang).
- Volume > 80: Fonem A (terbuka lebar).
6. Realita Sistem Saat Ini & Keterbatasan
Sistem Amadeus AI ini sekarang sudah berhasil jalan dan bisa diakses secara publik.
Namun, karena keterbatasan biaya dan mengandalkan resources seadanya:
- Pemrosesan konversi RVC memakan waktu ~22 detik tersendiri dari total delay ~26 detik karena dikerjakan oleh CPU VPS tanpa GPU.
- Interaksinya masih berbasis request-response sekuensial biasa sehingga belum bisa se-instan sistem streaming berbayar.
Meskipun masih terbatas di kecepatan dan biaya, proyek iseng dari kosan ini setidaknya berhasil wujud jadi sistem AI interaktif yang bisa diajak ngobrol langsung lewat suara dan teks.